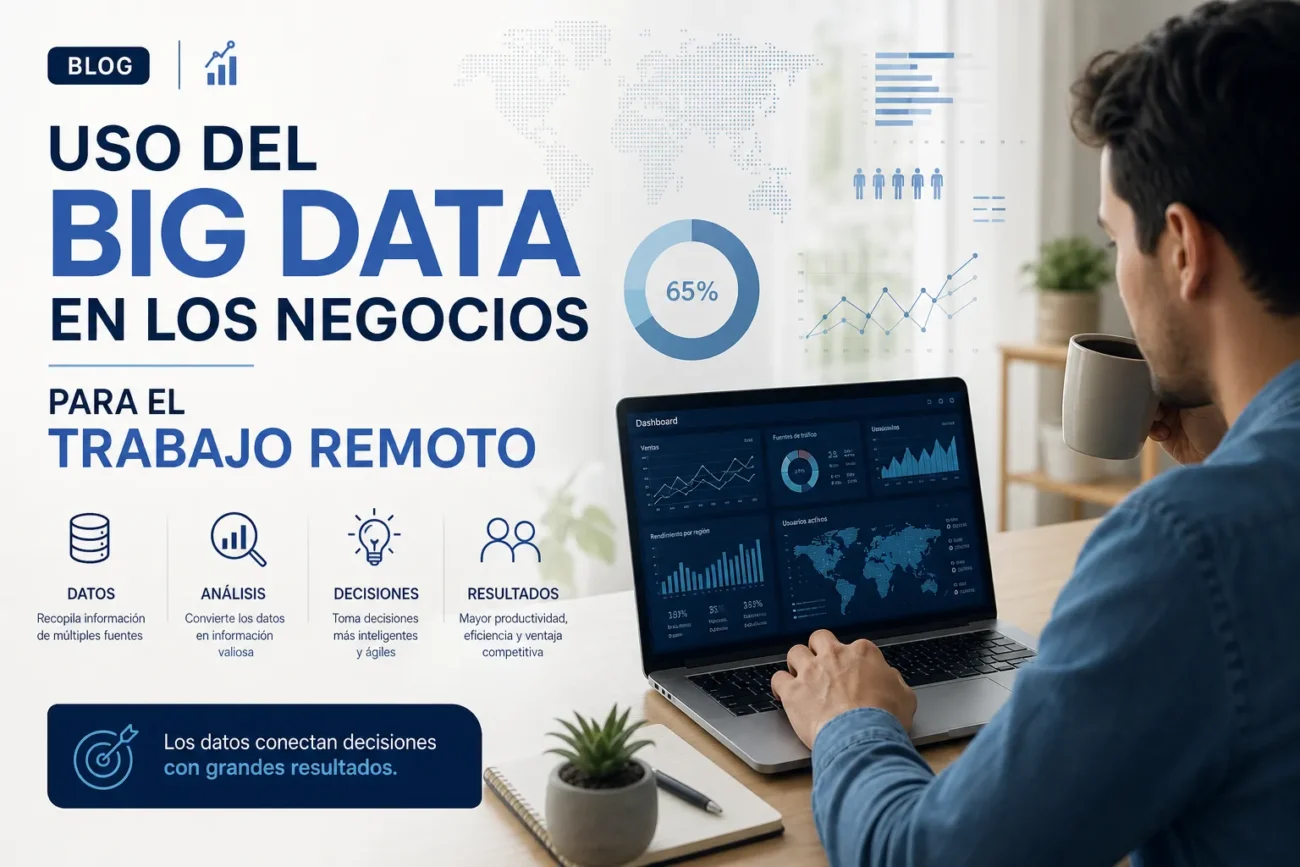
Uso del Big Data en los negocios para el trabajo remoto: qué es y por qué importa
Big Data en el contexto del trabajo remoto se refiere a la recopilación y análisis de grandes volúmenes de datos generados por herramientas de comunicación, colaboración, sistemas de gestión de proyectos y dispositivos de los empleados. Estos datos pueden incluir patrones de uso de aplicaciones, tiempos de respuesta, flujos de trabajo digitales y métricas de rendimiento, y permiten a las empresas transformar información dispersa en insights accionables para gestionar equipos distribuidos.
Su importancia para los negocios radica en que facilita una toma de decisiones basada en evidencia: optimiza la asignación de recursos, identifica cuellos de botella en procesos remotos y mide la productividad real en lugar de confiar solo en percepciones. Además, el análisis continuo de datos ayuda a personalizar la experiencia del empleado, mejorar la colaboración entre equipos y ajustar políticas de trabajo remoto según indicadores concretos como adopción de herramientas, cumplimiento de objetivos y satisfacción laboral.
En la práctica, las empresas usan Big Data para monitorizar KPIs de rendimiento, predecir picos de carga de trabajo, detectar necesidades de formación y anticipar riesgos de rotación o baja productividad. Para que estas aplicaciones sean efectivas es imprescindible garantizar la calidad de los datos, implementar medidas de seguridad y privacidad, y definir métricas claras que conecten el análisis con objetivos de negocio y bienestar del equipo remoto.
Beneficios del uso del Big Data en los negocios para optimizar el trabajo remoto
Big Data permite a las empresas optimizar el trabajo remoto mediante la centralización y el análisis de grandes volúmenes de información operativa y de rendimiento. Con dashboards en tiempo real y métricas clave, los equipos directivos pueden identificar cuellos de botella, ajustar procesos y priorizar tareas basadas en datos, mejorando la toma de decisiones y alineando objetivos entre oficinas y trabajadores distribuidos. Esta visibilidad contribuye a diseñar flujos de trabajo más eficientes y personalizados según el comportamiento y necesidades de cada equipo remoto.
El uso de análisis avanzado y modelos predictivos impulsa la productividad y la colaboración en entornos de teletrabajo al detectar patrones de comunicación, horarios pico y herramientas más efectivas. La automatización de informes y alertas reduce la carga administrativa, facilita la asignación óptima de recursos y permite reaccionar a problemas de rendimiento antes de que afecten proyectos clave. Integrar Big Data con plataformas de comunicación y gestión de proyectos mejora la sincronización entre miembros y la continuidad operativa.
Además, el Big Data refuerza la seguridad, la conformidad y la experiencia del empleado en el trabajo remoto a través de la monitorización de accesos, la detección de comportamientos anómalos y el análisis de riesgos. Estas capacidades ayudan a reducir costes operativos y a anticipar necesidades de infraestructura (ancho de banda, herramientas SaaS, soporte técnico), favoreciendo tanto la continuidad del servicio como la retención del talento remoto mediante políticas basadas en evidencia.
Cómo implementar el uso del Big Data en tu empresa para mejorar el trabajo remoto: guía paso a paso
Para implementar el uso del Big Data en tu empresa y mejorar el trabajo remoto es clave comenzar definiendo objetivos claros (mejorar productividad, colaboración y experiencia del empleado) y las métricas que van a medir esos objetivos. Identifica las fuentes de datos relevantes (herramientas de comunicación, plataformas de proyecto, logs de acceso y desempeño) y realiza un inventario de datos y permisos antes de diseñar la solución técnica.
Pasos esenciales
- Evaluar necesidades y fuentes: prioriza casos de uso de alto impacto para trabajo remoto (monitorización de rendimiento, análisis de tiempos de respuesta, detección de cuellos de botella).
- Diseñar arquitectura e infraestrucutra: opta por soluciones en la nube o híbridas que soporten ingestión, almacenamiento y procesamiento escalable, con cifrado y control de accesos.
- Seleccionar herramientas y pipelines: establece pipelines de ingestión, procesamiento y dashboards de analítica que se integren con las plataformas de colaboración existentes.
- Integración y automatización: conecta insights a flujos de trabajo remotos (alertas, asignación automática de tareas, recomendaciones) para convertir datos en acciones operativas.
- Formación y gobierno de datos: capacita equipos remotos en uso de dashboards y políticas de seguridad, y define roles, responsabilidades y cumplimiento normativo.
Mide el impacto con KPIs relevantes al trabajo remoto (tiempo medio de respuesta, productividad por equipo, adopción de herramientas, incidentes de seguridad) y configura dashboards en tiempo real para seguimiento. Implementa ciclos iterativos: valida hipótesis con pilotos, ajusta pipelines y modelos según feedback del equipo remoto y escala paulatinamente manteniendo controles de seguridad y privacidad.
Herramientas y tecnologías clave de Big Data para equipos remotos
Para equipos remotos que trabajan con Big Data, la base tecnológica suele apoyarse en proveedores cloud y soluciones de almacenamiento escalable que facilitan el acceso compartido y la gestión centralizada de datos. Plataformas como AWS, Google Cloud Platform y Microsoft Azure ofrecen servicios de almacenamiento (S3, Google Cloud Storage, Azure Blob) y capacidades de data lake que permiten a los equipos remotos consultar y versionar grandes volúmenes de datos sin depender de infraestructuras locales. Estas opciones reducen la latencia de colaboración y simplifican la configuración de permisos y auditoría.
En cuanto al procesamiento y la orquestación de pipelines, las tecnologías distribuidas y containerizadas son clave para mantener entornos reproducibles entre miembros remotos. Frameworks de procesamiento como Apache Spark o Apache Flink permiten ejecutar transformaciones y análisis a gran escala, mientras que herramientas de orquestación y despliegue como Apache Airflow, Kubernetes y soluciones serverless facilitan la programación, escalado y monitorización de flujos de trabajo. Juntas, estas tecnologías permiten separar el desarrollo local de la ejecución en clústeres gestionados.
La colaboración, el versionado y la observabilidad cierran el ecosistema de herramientas imprescindibles para equipos distribuidos. Plataformas como Databricks o integraciones con Delta Lake y MLflow soportan notebooks compartidos y control de experimentos; sistemas de mensajería y streaming como Apache Kafka (o servicios gestionados equivalentes) habilitan ingestión en tiempo real; y herramientas de BI como Tableau, Power BI o Looker facilitan la visualización y consulta colaborativa. Para garantizar operaciones seguras y confiables, se emplean además soluciones de monitoreo y logging (Prometheus, Grafana, ELK) junto con prácticas de IAM y cifrado en tránsito y reposo.
Casos prácticos, métricas y retos del uso del Big Data en los negocios para el trabajo remoto
Métricas clave
En casos prácticos de Big Data aplicados al trabajo remoto, las empresas suelen usar soluciones de análisis para monitorizar productividad, colaboración y experiencia del empleado sin perder foco en la privacidad. Aplicaciones típicas incluyen análisis de flujos de trabajo para detectar cuellos de botella en equipos distribuidos, análisis de atención al cliente remoto para optimizar tiempos de respuesta y sistemas de seguridad que correlacionan logs para proteger accesos desde entornos domésticos.
Las métricas más relevantes para valorar iniciativas de Big Data en trabajo remoto incluyen:
- Tiempo medio de finalización de tareas y tasa de cumplimiento de objetivos.
- Frecuencia y calidad de colaboración (reuniones efectivas, intercambio de documentos, redes de comunicación).
- SLA y tiempos de resolución en soporte remoto; latencia y disponibilidad de servicios.
- Métricas de experiencia del empleado: encuestas de sentimiento, rotación potencial y engagement.
- Indicadores de seguridad: eventos anómalos, intentos de acceso y cumplimiento de políticas.
Entre los principales retos se encuentran la protección de datos personales y el cumplimiento normativo (por ejemplo, GDPR), la integración de datos heterogéneos de múltiples herramientas remotas, la calidad y consistencia de la información recogida, y el riesgo de sesgos al interpretar comportamientos digitales como productividad. Además, los costes de infraestructura para procesamiento en tiempo real y la necesidad de transparencia para mantener la confianza de los empleados son desafíos recurrentes.
Para abordar estos retos, las organizaciones deben implementar gobernanza de datos clara, anonimización y técnicas de minimización, pipelines que soporten batch y streaming según necesidad, y métricas de rendimiento de modelos que permitan validar y auditar resultados. La adopción efectiva del Big Data en el trabajo remoto exige equilibrar valor analítico con seguridad, ética y escalabilidad.